Documentos internos de Microsoft calificaban el entrenamiento de IA como un gran robo
Nuevos documentos desclasificados revelan que en Microsoft sabían que entrenar la IA con prensa era, en sus propias palabras, el mayor robo laboral de la historia.
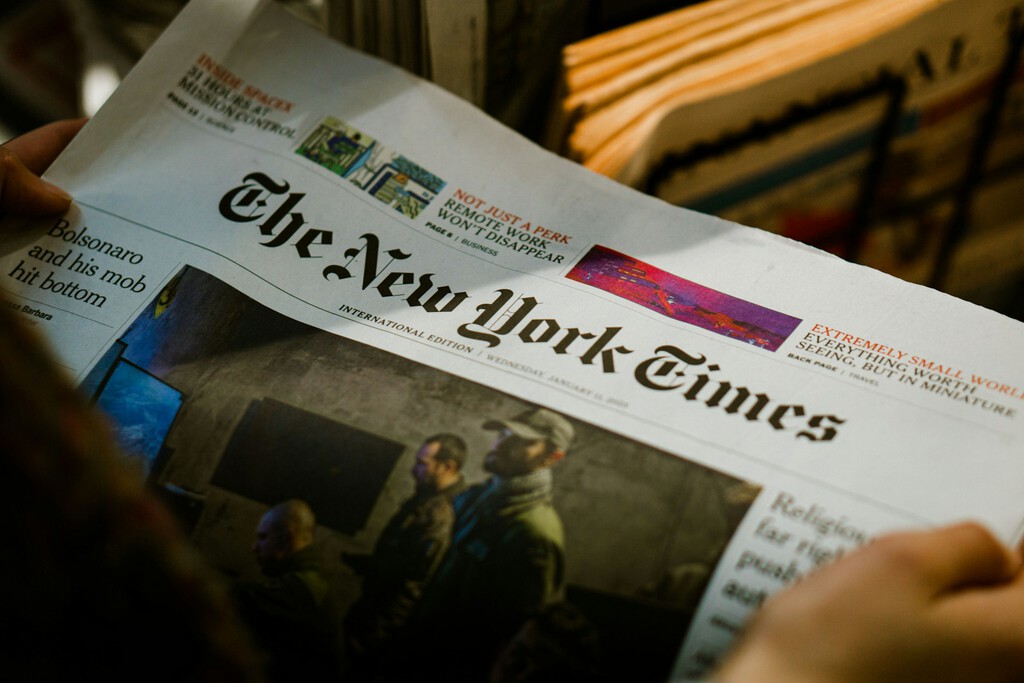
A finales de 2023, el periódico New York Times llevó a OpenAI y Microsoft ante los tribunales por usar sus artículos para entrenar modelos de inteligencia artificial sin pedir autorización ni compensarles de ninguna manera. A esa demanda se terminaron sumando otros once medios de comunicación. Sin embargo, lo más revelador ha salido a la luz ahora, tras desclasificarse varios documentos internos que demuestran que dentro de las propias tecnológicas había voces muy conscientes de lo que estaban haciendo.
Y es que en las oficinas de Microsoft no se andaban con rodeos. En un documento de 2023 escrito por Brent Hecht, director de ciencia aplicada de la compañía, se calificaba la práctica de entrenar IA con prensa como "el mayor robo laboral de la historia". En dicho escrito se hacía referencia explícita al hecho de que OpenAI, su socio más fiel por aquel entonces, estuviese alimentando sus modelos con artículos periodísticos.
Brent Hecht no se quedó corto en sus reflexiones internas. Aseguró que millones de personas en todo el mundo pronto considerarán que el hecho de que los grandes modelos de IA "absorban" todo su trabajo representa un robo asombroso de proporciones sin precedentes. Para entenderlo con una analogía sencilla: es como si utilizas todo el material de una fábrica ajena para construir tu propio producto sin pagar las piezas.
Además, el directivo mostró una clara preocupación por lo que podía ocurrirle a la industria periodística. En el documento aseguraba que estos modelos de inteligencia artificial son un producto que destruye directamente su propia cadena de suministro. Es decir, si se liquida a los medios que producen la información, la propia tecnología se queda sin la materia prima necesaria para seguir aprendiendo.
Estos papeles desclasificados dejan patente que la discusión ética existía desde dentro mientras la IA devoraba miles de textos. ¿Qué opinas sobre el uso de contenidos con derechos para entrenar estos modelos? ¡Queremos conocer tu punto de vista y debatir contigo en la comunidad BeersStorming!
Fuente original: Xataka